📚 本文是 AI 工具完全指南(2026) 系列的进阶教程。想先系统了解 ChatGPT、Gemini、Kimi 这些大模型的选型和基础用法,看总览页;这篇讲一个具体的高级玩法——用 AI 把零散的笔记、文章、对话沉淀成一套会自己进化的个人知识库。
很多人试过各种知识管理方法:卢曼卡片盒、PARA 分类法、双链笔记……但最后都卡在同一个地方——知识整理比学习本身还累。每天花大量时间归置、打标签、建链接,结果没几天就坚持不下去。
这篇文章分享一套思路,解决的就是这个问题:让 AI 替你承担知识库的重复维护,你只负责往里面丢资料和做关键判断。这套方法的原型,是 Karpathy 公开的 LLM wiki 知识库构建方法。
文章比较长,但值得看完——核心就两部分:这套系统为什么比传统玩法强,以及三种由易到难、可以直接上手照做的搭建方法。
30 秒速答
- LLM Wiki 是什么:给 AI 安排「长期维护知识库」的工作,每进一份资料就增量更新,让知识持续积累——比 RAG 那种「答完就散」强。
- 三层架构:Raw 存原始资料(只读)、Wiki 存 AI 整理的概念/实体/主题、Schema(AGENTS.md)定规则。
- 用什么工具:Obsidian(笔记底座)+ WorkBuddy / Codex(Agent 执行),三者按难易分三种搭法。
- 新手从哪起步:直接上方法三(WeSight 插件,点几下就好);想懂原理再回头用方法一。
- 模型怎么选:选上下文长的;看重性价比用 DeepSeek,要处理图文用 Kimi。
- 注意:装 Obsidian 插件、下 Agent 工具都要先解决网络访问,记得开代理。
一、先说清楚:LLM Wiki 到底要解决什么问题
现在主流的「AI 问答」玩法,不管是 RAG 系统还是各种文件上传功能,本质是同一套流程:你先上传资料,提问时模型召回相关知识片段,再临时综合出一个答案。
听着挺智能,但有个明显的问题被忽略了:每次提问,模型都在从碎片里重新拼答案,答完就散。 同样的问题问一百遍,它就重新拼一百遍,知识本身没有任何积累。
LLM Wiki 的思路是反过来——给 AI 安排一份长期工作:持续维护知识库。
每加入一份资料,Agent 都会先查看现有页面:
- 已有内容会被补充;
- 新概念会单独建页;
- 遇到不同观点,把来源、时间和适用范围一起留下。
这样知识的分歧就有迹可循,也不会被一段看似完整的总结悄悄抹掉。「自生长」的关键就在这里——AI 处理完资料后,知识库必须留下变化。它可能新增一个概念、补上一条关联,也可能暴露一个暂时没有答案的问题。一次次变化累积起来,才会形成真正属于自己的知识体系。
二、三层架构:Raw 保存证据,Wiki 记录理解,Schema 定规则
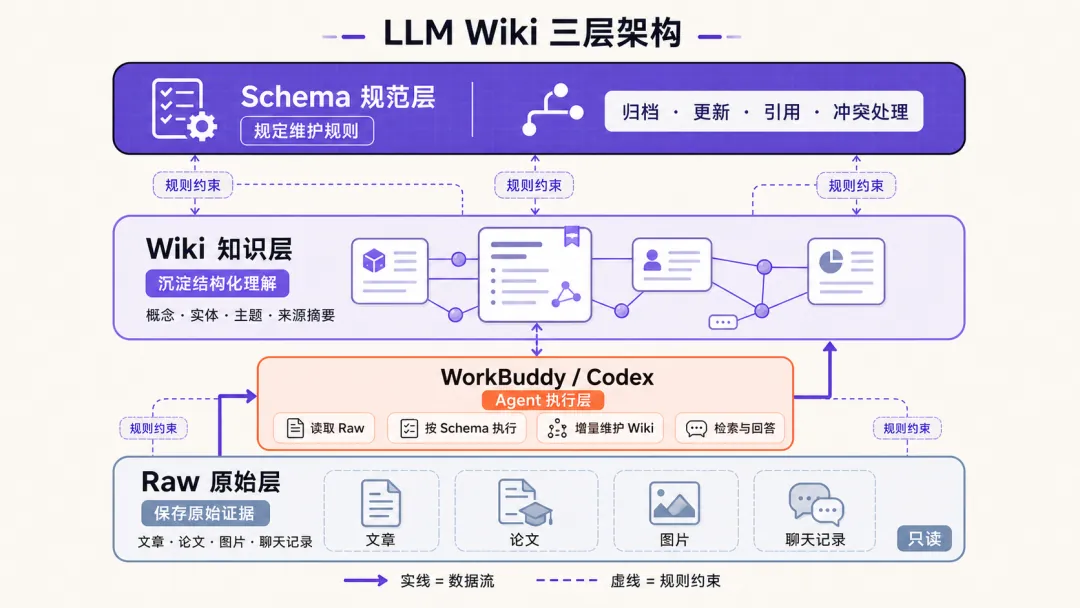
为了让整个过程可控,整套系统分成三层:
- Raw 层:保存文章、论文、聊天记录等原始资料。这层是「事实来源」,只读,AI 不允许改。
- Wiki 层:沉淀 AI 整理出的概念、实体、主题页。这是「理解层」,AI 全权维护。
- Schema 层:通过一份工作说明书,规定 AI 如何归档、更新、引用,以及怎么处理冲突。
一句话把握:Raw 保存证据,Wiki 记录理解,Schema 负责定规则。
后面所有的实战,本质上就是让这三层真正运转起来。
三、为什么用 Obsidian,而不是 Notion / Ima / NotebookLM?
这套系统选 Obsidian(而非 Notion、Ima、NotebookLM 这类云端产品),有四个实打实的理由:
- 完全本地化、数据自主。一个仓库就是电脑上的普通文件夹,笔记以 Markdown 纯文本保存,不依赖某个平台的页面数据库。聊天记录、会议纪要这些私人资料留在自己设备上,同步到哪、怎么同步,都由你决定。说白了,工具可以换,知识不用跟着搬家。
- 文件形态天然适合 Agent 干活。WorkBuddy / Codex 可以直接读目录、创建页面、改链接、维护索引,每次变化都能定位到具体文件,还能用 Git 留痕。
- 双链和知识图谱把概念、人物、工具、主题连起来,帮你发现核心节点、孤立页面和新的关联。
- 插件生态提供扩展空间,从模板、查询、版本管理到发布、可视化都能按需加。
在这套系统里,Obsidian 承担存储底座、人机界面、知识观察窗口三种角色;WorkBuddy / Codex 负责执行,Obsidian 负责保存、连接和呈现。对于要长期用的个人知识库,本地自主、结构开放、变更可追踪、能力可扩展,这四点就够了。
四、AI 在这套系统里做什么
AI 承担的是「执行与编排」,人负责「定规则、检查结果、关键判断」。
具体来说,当新资料进入 Raw 层后,Agent 会:
- 理解内容,识别其中的概念、实体、主题;
- 与现有 Wiki 对照——已有知识补充、新内容建页、相关知识建链接;
- 遇到不同说法,保留来源、时间和适用范围;
- 同步更新索引与变更记录。
到了查询和维护阶段,Agent 还负责检索相关页面、整理答案、追溯来源,并批量检查失效链接、缺失字段、长期没更新的内容。
整个过程都是增量维护,不需要反复重建整套知识库。知识管理从「大量手工整理」,逐渐变成「人机协作的持续维护流程」。
五、实战:从零搭一套 LLM Wiki
进入实战。这里的 Agent 你可以用 Codex、Claude Code,也可以用 WorkBuddy;模型建议选上下文长一些的。
选模型的几个建议:追求极致性价比,可选 DeepSeek 这类非多模态长上下文模型(可惜不支持多模态);需要处理图文资料,选 Kimi 这类原生多模态模型。一个避坑提醒:别用 Codex 里的 GPT 5.6 Sol,用量实在太猛了。关键判断标准:用你自己的真实资料跑一遍完整任务,重点观察上下文是否丢失、工具调用是否稳定、输出格式是否漂移,以及单次任务的时间和成本。
准备工作
需要准备两样:Obsidian(新建一个仓库 Vault),以及 WorkBuddy 或 Codex 这类 Agent 工具。
⚠️ 提醒一句:全程记得开代理,尤其是访问 Obsidian 插件市场、下载 Agent 工具的时候。这一步的网络问题怎么解决,看 科学上网完全指南,机场、VPN、自建三种方案一次讲清。
三层目录结构
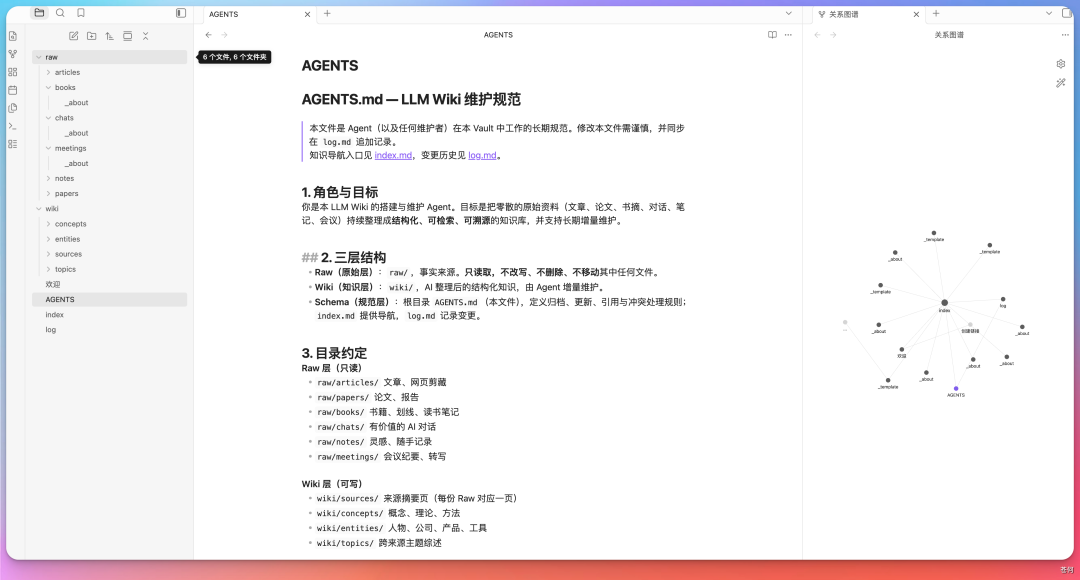
这是三层架构的标准目录模板,可以直接复用:
my-wiki/
├── AGENTS.md            ← Schema 规范层:给 AI 的工作说明书(核心)
├── index.md             ← 全局索引 / 站点地图(AI 定位知识的入口)
├── log.md               ← 变更日志(只追加,谁改了什么一目了然)
│
├── raw/                     ← 原始资料层(只读,AI 不许改)
│   ├── articles/            ← 剪藏的文章、网页
│   ├── papers/              ← 论文、报告
│   ├── books/               ← 书籍、划线、笔记
│   ├── chats/               ← 有价值的 AI 对话记录
│   ├── notes/               ← 自己随手记的灵感碎片
│   └── meetings/            ← 会议纪要转写
│
└── wiki/                    ← Wiki 层(AI 全权维护)
    ├── sources/             ← 来源摘要页:一份 raw 资料对应一页
    ├── concepts/            ← 概念页:方法论、理论、模式
    ├── entities/            ← 实体页:人物、公司、产品、工具
    └── topics/              ← 主题综述页:某个领域的综合对比
六、三种搭建方法(由难到易)
我实践下来有三种方法,从「需要理解原理」到「基本傻瓜式」,按上手难易度依次介绍。
方法一:直接让 Agent 按提示词搭建
这是最「原始」但理解最深的方法——直接把下面这段提示词丢给 WorkBuddy 或 Codex,让它按三层架构建目录和 AGENTS.md。
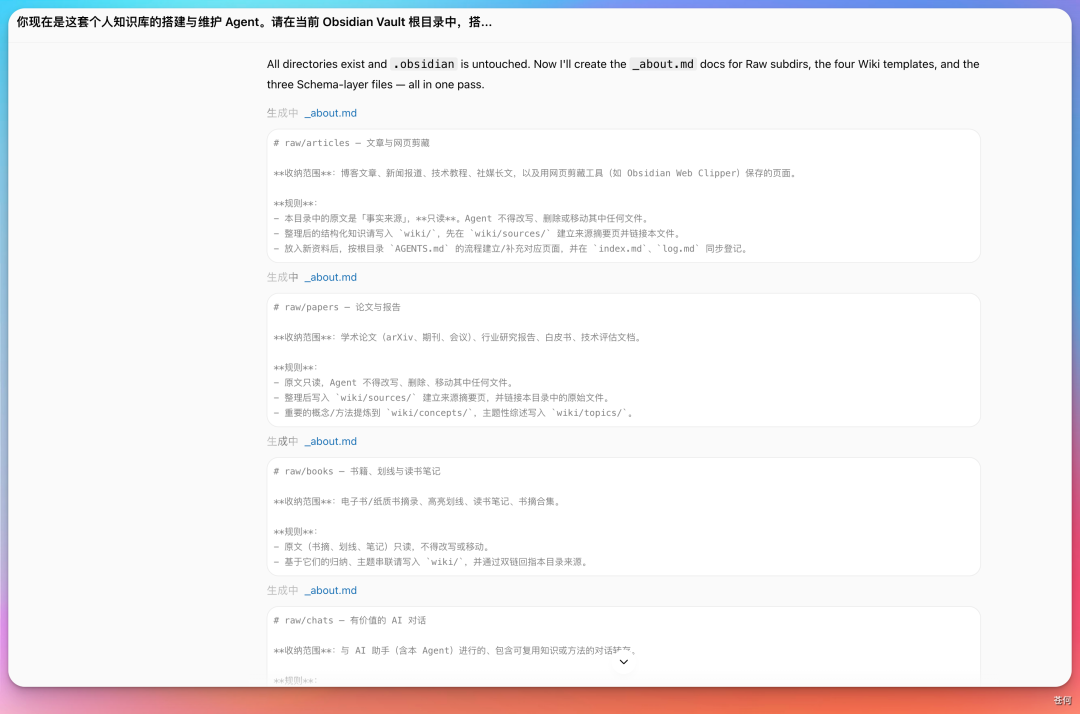
提示词(可直接复用):
你现在是这套个人知识库的搭建与维护 Agent。请在当前笔记仓库根目录中,搭建一套可长期增量维护的 LLM Wiki。

## 目标
建立 Raw、Wiki、Schema 三层结构:
- Raw 层保存原始资料,只允许读取,不修改原文。
- Wiki 层保存 AI 整理后的结构化知识,由 Agent 增量维护。
- Schema 层通过根目录下的 AGENTS.md 定义归档、更新、引用和冲突处理规则。

## 需要创建的结构
- AGENTS.md:Agent 的长期工作规范
- index.md:全局索引和知识导航入口
- log.md:变更日志,只追加新记录
- raw/articles/、raw/papers/、raw/books/、raw/chats/、raw/notes/、raw/meetings/
- wiki/sources/、wiki/concepts/、wiki/entities/、wiki/topics/

## AGENTS.md 必须包含的规则
1. 处理新资料前,先搜索 wiki/ 中已有的相关页面,判断补旧页还是建新页。
2. raw/ 是事实来源,禁止改写、删除或移动其中的文件。
3. 每份 Raw 资料在 wiki/sources/ 建立对应的来源摘要页,并保留原始文件链接。
4. 概念、实体、主题用独立页面,通过双链建立关系。
5. 所有事实性内容标注来源;无法确认的写为「待核实」。
6. 新旧资料分歧时,同时保留不同说法及其来源、时间、适用范围,不直接覆盖旧结论。
7. 每次只更新受影响的页面,同步维护双链、index.md 和 log.md。
8. log.md 只追加,记录日期、资料来源、新建/更新页面、待人工确认事项。
9. 不擅自删除现有文件;同名文件已存在先读取合并,保留原内容。
10. 信息不足或可能影响整体结构时,暂停执行并向我提问。

## 页面模板
在 wiki/sources、concepts、entities、topics 中分别创建 _template.md,
使用 Obsidian 兼容的 YAML 属性,至少包含 title、type、aliases、tags、
sources、created、updated;正文预留摘要、核心内容、相关页面、来源与待核实区域。

## 执行与验收
执行前先检查当前目录确认是笔记仓库;无法确认先问我。
随后创建缺失的目录和文件,不覆盖已有内容。完成后自检并汇报:
新建了哪些目录和文件、哪些被保留或合并、AGENTS.md 重要规则、结构是否通过、下一步放测试资料到哪。
Agent 会按规则建好目录结构和 AGENTS.md。
验证方式:用浏览器剪藏插件(Obsidian Web Clipper)把一个网页文章保存到 raw/articles 目录,然后继续给 Agent 下发「入库」提示词:
请读取 raw/articles/ 中新增的文章,严格按照 AGENTS.md 规则增量维护 Wiki。
处理前先检索现有页面:为文章创建来源摘要,提取概念、实体、主题;
已有内容补充到原页面,新内容创建页面,不同观点保留来源、时间和适用范围。
随后建立双链,更新 index.md 与 log.md。不要修改 raw/ 中的原始文件。
完成后告诉我新建、更新了哪些页面,以及有哪些内容需要人工确认。
Agent 会按 AGENTS.md 建立实体页、概念页、来源摘要页、主题综述页,一次可能新建近十个页面。
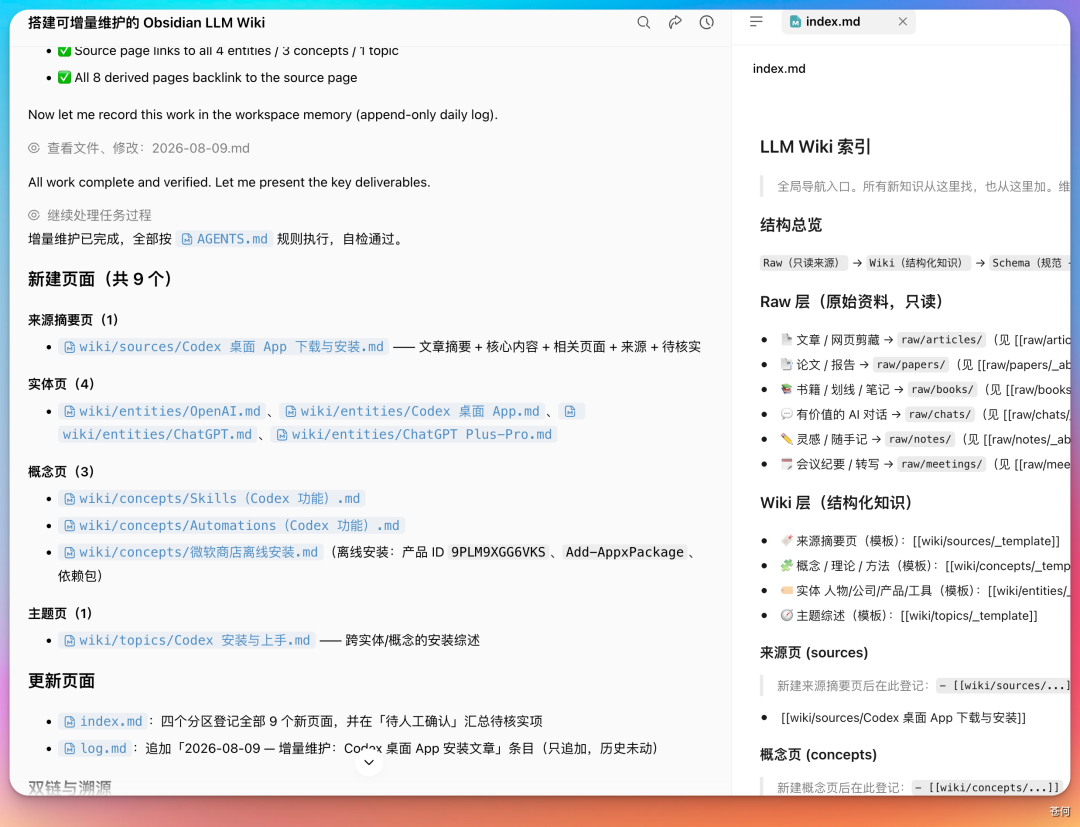
这些 Wiki 页面的价值不只是「能读」,更重要的是成为 Agent 的长期检索层和推理底座。之后你再提问时,Agent 先检索已沉淀的 Wiki、再沿着双链回原始资料,回答就有依据、可追溯。随着资料增多,这层中间知识持续积累,查询和维护越来越高效。
比如你可以这样提问:
请基于刚入库的文章和现有 Wiki,回答:文章提出了哪些核心观点?
涉及的概念、实体、主题之间是什么关系?哪些结论能转化为可执行的行动建议?
回答时标注引用的 Wiki 页面和 Raw 原文路径;有不同观点、信息缺口、待核实内容也单独列出。
方法一的缺点也明显:对提示词和工程化理解要求高,AGENTS.md 要不断调整以适应自己的需求。
方法二:claude-obsidian 插件
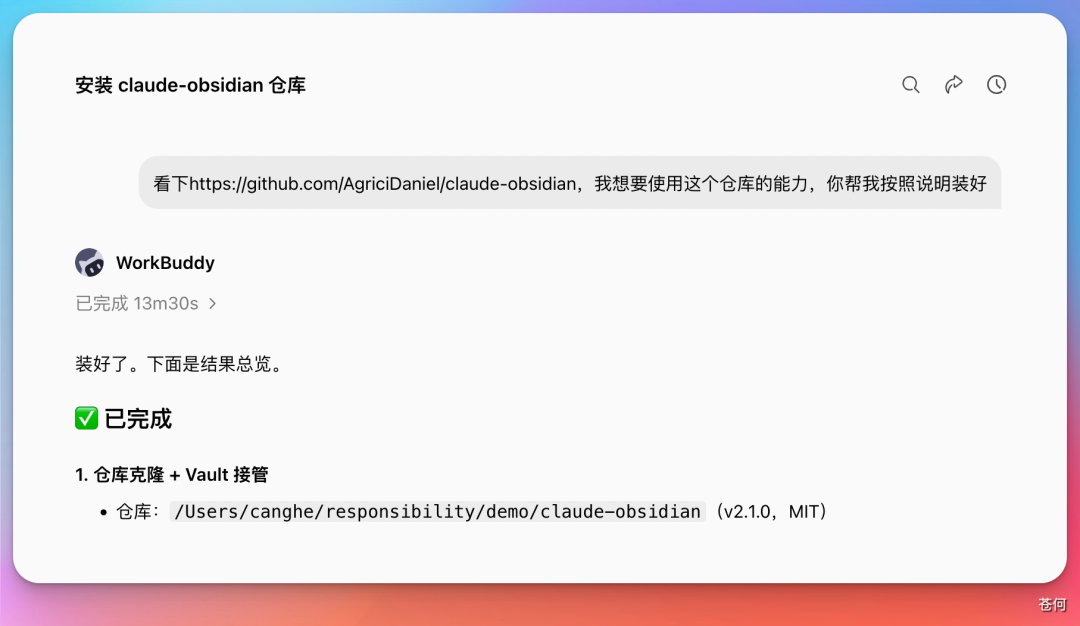
有开发者已经基于 LLM wiki 这套理论做成了工程化成熟度较高的开源项目,叫 claude-obsidian,把常用方法封装成了插件和 Agent Skill:初始化知识库、保存笔记到 wiki、自动索引和链接,都不用自己写提示词了。
你只需要在 WorkBuddy / Codex 里安装这个项目,当前仓库就会自动创建结构,然后:
- 用
ingest指令把新素材同步进 wiki; - 用
retrieve指令从知识库快速查询; - 甚至不用显式指定,Agent 会自动命中知识库里的 wiki 来检索。
方法二比方法一更进一步:初始化、入库、索引、检索都封装好了,省去反复写提示词和维护复杂规则。但它仍然有个门槛——主要操作发生在 WorkBuddy / Codex 里,你要理解并调用 ingest、retrieve 这些指令,Obsidian 更多只是承担文件存储和结果浏览,任务状态、执行过程、知识变化缺少可视化反馈。
方法三:WeSight 知识大脑插件(最省事)
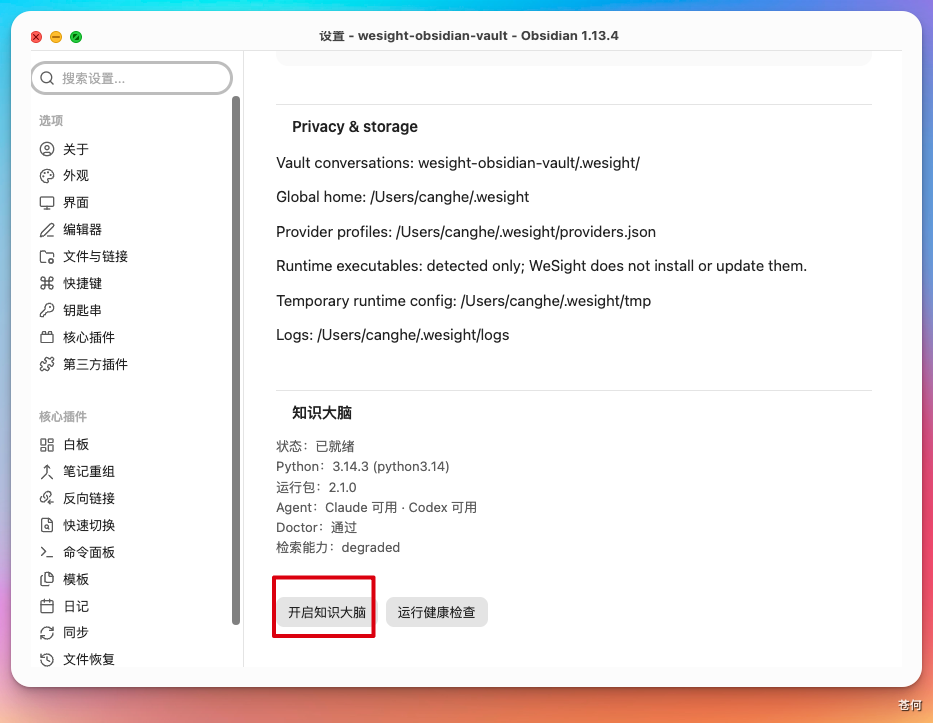
WeSight 插件把「知识库初始化、资料入库、Wiki 更新、智能检索」全部整合进了 Obsidian 内部——你在熟悉的笔记界面里点几下,后台的 Agent 就帮你完成结构维护和持续更新。
WeSight 的典型用法:
- 开启「知识大脑」能力,插件自动为你的仓库配置好环境结构;
- 一键把当前笔记加入知识大脑对应的 wiki;
- 提问时选「基于知识库」模式,插件优先检索已沉淀的 Wiki、沿双链定位概念和来源,自动完成检索、引用、上下文装配;
- 还能把与 Claude Code、Codex 的聊天记录一键保存进知识库,继续沉淀为长期资产。
方法三的门槛最低,适合第一次接触这套架构的人直接上手。
七、为什么这套组合能「自生长」
「自生长」来自知识结构的持续增量更新:每进一份新资料,Agent 按 Schema 检索现有 Wiki,补充旧页、建新节点、连双链、记录来源与观点冲突。每次处理都留下可复用的结构化结果,知识库随输入不断演化。
整个闭环是:人输入高价值资料 + 做关键判断,Agent 承担重复维护,数据、规则、执行各自就位。
资料搜集方面,手机上可以配合 ima 或其他剪藏工具收集文章和灵感,电脑端用 Obsidian Web Clipper 浏览器插件一键剪藏,散落在各处的文档(比如飞书)也可以让 Agent 批量收藏进知识库。
八、写在最后
这套系统带来的最大变化,是让知识管理从「一次性的手工整理」变成「一套可持续运行的维护机制」。文章、笔记、对话、灵感进入 Raw 后,Agent 按规则归档、关联、更新,零散资料逐步长成属于自己的知识网络。
但「自生长」不等于全自动。哪些资料值得留、规则怎么定、关键结论能不能成立,仍然需要人的判断;AI 更适合承担重复、耗时、结构化的维护。人和 Agent 各管擅长的部分,知识管理才坚持得下去。
如果你也想试,别一上来就追求完美系统。先建好三层目录,放进一篇真实资料,让 Agent 完成第一次增量更新,再根据实际使用不断调整 Schema。只要每次输入都能留下可复用的结果,知识库就已经开始生长了。
- 想系统了解主流大模型怎么选、怎么用,看 AI 工具完全指南(2026);把个人知识库的数据安全和隐私风险搞明白,看 企业使用 AI 大模型如何保障数据安全。