DeepSeek 前两天崩了近 5 个小时,随后把过去一周的消耗金额全部返还——这波补偿还没消化完,10 月 17 日下午官方又悄悄发了个新版本:V4.1 Flash 升级到 V4.1-Flash-1017。
这个名字看起来只是多了个日期(1017 就是 10 月 17 日),但对比上一版,11 项基准测试全部上涨,跑同一批任务的成本还降了六成。API 单价一分没动,调用方式一分没变,模型名还是 deepseek-flash——什么都没变,跑分涨了,账单薄了。
这篇把这次升级讲透:跑分涨在哪、钱是怎么省下来的、「许愿式编程」实际体验如何(含翻车案例),以及 11 月 1 日一个和所有 Agent 用户有关的计费变化。
30 秒速答
- 是什么:V4.1 Flash 的版本升级,10 月 17 日发布,网页端 / APP / API 已全部同步,模型名不变(deepseek-flash),价格不变,老用户无感升级。
- 强多少:11 项基准全涨,DeepSWE v1.1 拿 77.0% 是六个模型最高;但 11 项里有 6 项第一仍是 Claude Opus 5,优势集中在 Agent 任务和性价比。
- 省多少:同一批编程任务,单任务成本从上一版的 3.3 元降到约 1.3 元,Claude Opus 5 跑同样的活约 79 元——约 60 倍差距。
- 怎么用:网页端打开就用;想体验完整「许愿式编程」,把 DeepSeek Harness 桌面端升到 0.2.1-rc.1 以上,选带 1017 标记的模型,新用户首登还有 6 元赠金。
一、1017 是个什么版本
先把背景捋清楚。V4.1 Flash 是 DeepSeek 9 月 10 日发布的主力模型(原生多模态那次升级,站内有多模态实测),一个月后的这次 1017 是它的性能迭代——不是新模型,是同一个模型换了个更强的权重。
对使用者的变化小到几乎没有:
- 网页端和 APP:已经自动换新,打开就是新版,什么都不用做;
- API:模型名还是
deepseek-flash,调用方式和价格完全不变,下次请求自动就是新版; - 开源权重:HuggingFace 和魔搭同步上线,仓库名
DeepSeek-V4.1-Flash-1017,MIT 协议。
变化的全部内容浓缩在官方公告的一个经济学名词里:帕累托改进——性能全面提升的同时,任务运行时间和输出长度双双缩短,没有任何一项指标付出代价。下面分开算这两笔账。
二、跑分账:11 项全涨,但别只看「屠榜」
先上官方对比表(1017 对比上一版、Kimi K3、GLM 5.3、GPT-5.6 Sol、Claude Opus 5):
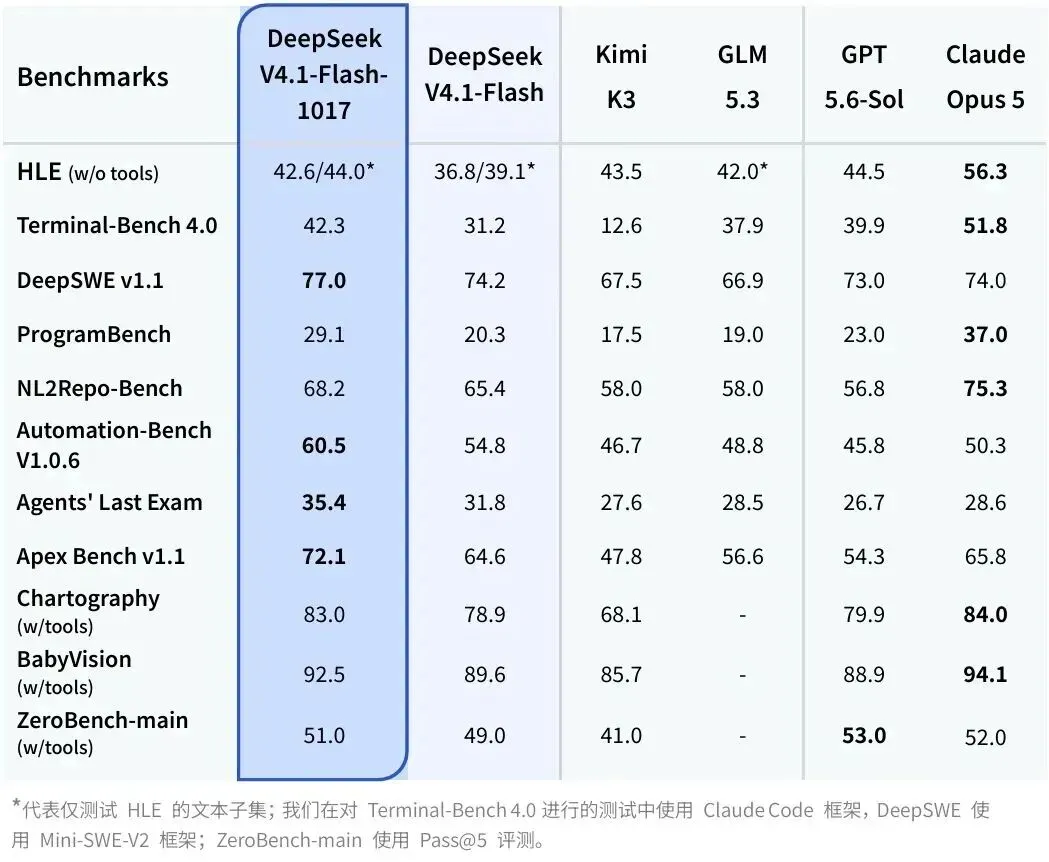
涨幅最大的一项是 Terminal-Bench 4.0:从 31.2 涨到 42.3,一次提升 11.1 个点。这个测试考的是终端和工具执行能力,上一版在这个坑里摔得不轻,这一版基本填平了——作为参照,GPT-5.6 Sol 是 39.9,Kimi K3 只有 12.6。
1017 拿下第一的四个项目全是 Agent 类:
| 基准 | 1017 成绩 | 第二名 |
|---|---|---|
| DeepSWE v1.1 | 77.0 | Opus 5(74.0) |
| Automation-Bench | 60.5 | Opus 5(50.3) |
| Agents’ Last Exam | 35.4 | Opus 5(28.6) |
| Apex Bench v1.1 | 72.1 | Opus 5(65.8) |
但要说清楚另一半:11 项里有 6 项的第一名仍然是 Claude Opus 5——HLE(56.3 对 42.6)、Terminal-Bench(51.8)、ProgramBench(37.0)、NL2Repo(75.3)、Chartography、BabyVision 都是。纯推理深度的天花板还在 Anthropic 手里。
另外这些都是 DeepSeek 自报分数,横向对比时各家评测框架未必对齐;不过纵向的版本对比(31.2 涨到 42.3 这种)是同一套框架跑出来的,可信度高得多。
所以定位很清晰:1017 不是「全面碾压 Opus 5」,而是把干活这件事做到极致——自动化任务领先,价格砍到脚踝。纯拼深度推理,Opus 5 依然是天花板。
三、成本账:单任务 3.3 元降到 1.3 元,60 倍的差距
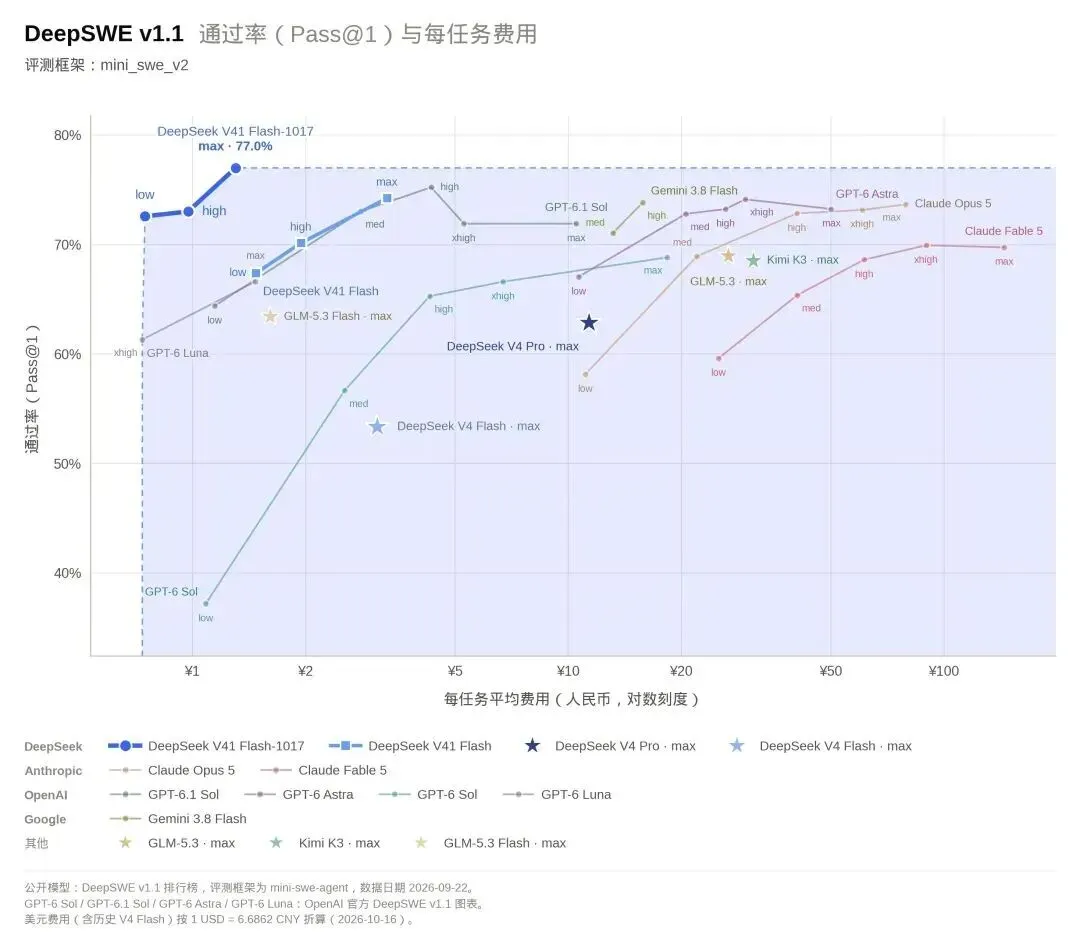
这次最狠的数字在官方的「性能-费用」图里。DeepSWE v1.1 同一批任务(mini-swe-v2 框架实测),把通过率和每个任务的平均费用放在一起看:
| 模型(档位) | 通过率 | 每任务费用 |
|---|---|---|
| V4.1-Flash-1017 · max | 77.0% | 约 ¥1.3 |
| GPT-6.1 Sol · high | 75.2% | 约 ¥4.3 |
| V4.1-Flash 上一版 · max | 74.2% | 约 ¥3.3 |
| GPT-6 Astra · xhigh | 74.1% | 约 ¥30 |
| Gemini 3.8 Flash · high | 73.8% | 约 ¥16 |
| Claude Opus 5 · max | 73.7% | 约 ¥79 |
| Claude Fable 5 · xhigh | 70.0% | 约 ¥90 |
三个信息:
- 同版本对比,成本降了六成:上一版 max 档 3.3 元,这一版 1.3 元,通过率还从 74.2% 涨到 77.0%。API 单价没降,钱是从「输出更短、跑得更快」省出来的——Agent 任务的账单大头从来不是单价,而是输出 token 总量乘以循环轮数,模型少说废话比降价更能省钱;
- low 档和 max 档只差 4.4 个点:low 档 72.6% 通过率、单任务约 0.75 元,max 档 77.0%、1.3 元。给简单任务路由到 low、疑难任务才开 max,成本还能再砍一刀;
- 和 Opus 5 的差距约 60 倍:当然这有汇率、框架和任务分布的因素,不能直接划等号。但对跑批量的工作流(代码巡检、数据清洗、批量测试)来说,很多「因为太贵不敢自动化」的流程,现在变得可算了。
API 省钱补充:DeepSeek API 分时段计费,北京时间工作日 9:00-12:00 和 14:00-18:00 是高峰价(双倍),其余时间含周末全天半价。批量任务调度到非高峰时段,token 成本直接减半。
四、许愿式编程:惊艳的和翻车的都在这
「许愿式编程」是这次 DeepSeek 主打的新概念:用很少的提示词和参考素材,几轮交互就从零做出能跑的完整项目。背后的训练方法是基于自反馈的强化学习——模型自己评估产出、自己修正,重点强化了游戏开发、3D 建模这类「从零搭项目」的能力。
官方自己放的 demo 是故宫 3D 建模、网页赛车游戏、用 Godot 引擎复刻的《传送门 2》(V 社至今没数到 3,DeepSeek 先帮玩家圆梦了)和 Valley of Ages(一片 3D 河谷从史前演到现代)。
真机上什么体验?有博主第一时间用 DeepSeek Harness 桌面端爆肝实测了一天,九个案例几乎全是一句话提示词。挑几个有代表性的(图片来自该博主的实测结果):
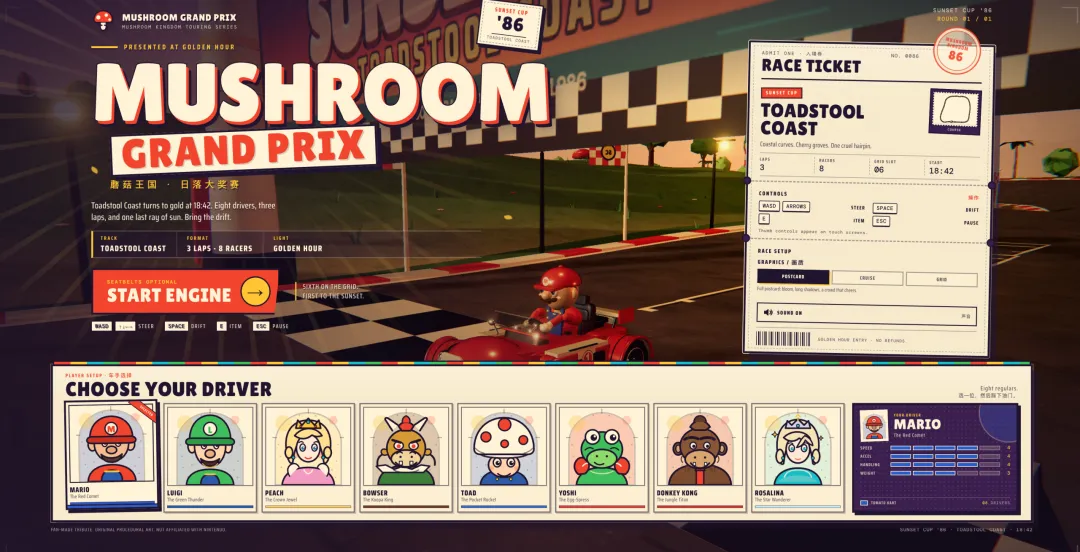
马里奥卡丁车是完成度最高的一个。同一句提示词,上一版 V4.1 Flash 做出来的游戏完全玩不了——跑道是歪的,车一动不动,NPC 倒是一发车就冲出去了;1017 吭哧吭哧干了 1 个小时,一次性直出,打开先给角色选择页,8 个角色任挑,能完整跑完三圈,道具都能用,落日赛道的光影也很出片:
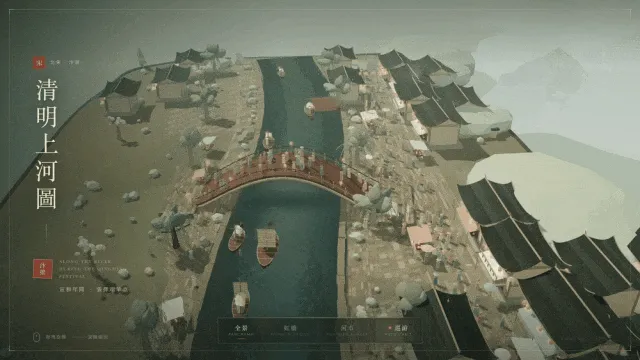
3D 清明上河图跑了 30 分钟,虹桥上挤满了人,河边的街市都建了出来,河面上的船还会自己游动:
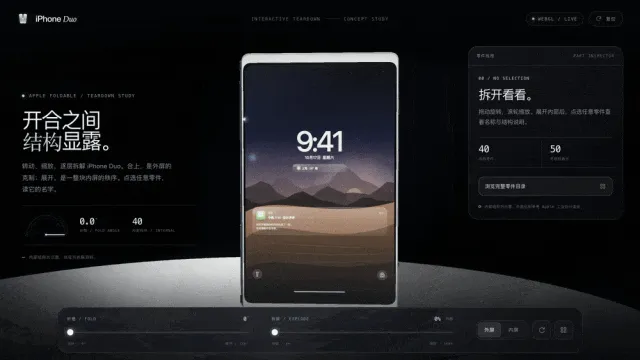
iPhone Duo 折叠屏 3D 模型:折叠和展开都做了,还能一键拆开,里面的零件一个个摆出来——对着真机建模的还原度相当能打:
对比项也没输:拿它和 GPT-6.1 Sol 比雨夜便利店街角场景,DeepSeek 那版把周围的建筑、马路和斑马线都搭了出来,整个街角比 GPT 版丰富;不过地面的雨水反光,GPT 版确实更胜一筹。
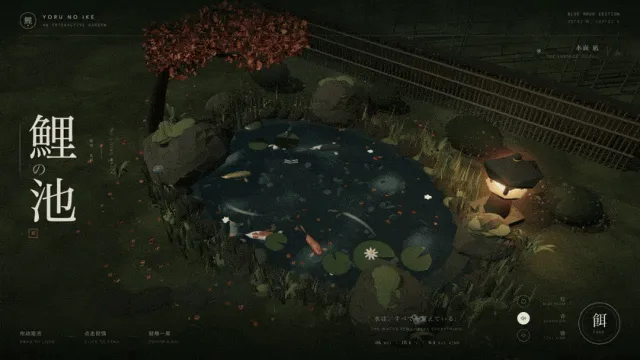
翻车案例也得说——平面 2D 锦鲤鱼塘做得像泥鳅,改成 3D 日式锦鲤池后明显好一些,但鱼是倒着游的。这个翻车反而有信息量:这次升级强化的就是 3D 建模方向,平面 2D 场景没有针对性优化,能力边界很清晰:
五、怎么用上:网页端零操作,Harness 要升级
按使用深度分三条路:
只聊天:网页端和 APP 已经是新版了,什么都不用做。
调 API:模型名不变(deepseek-flash),代码一行不用改,下次调用自动是新版。
要完整许愿式编程体验:用 DeepSeek 官方的 Agent 框架,官方这次专门针对它做了优化。安装和四种模式的详细教程看站内的 DeepSeek Harness 完全教程,这里只说这次升级要做的两步:
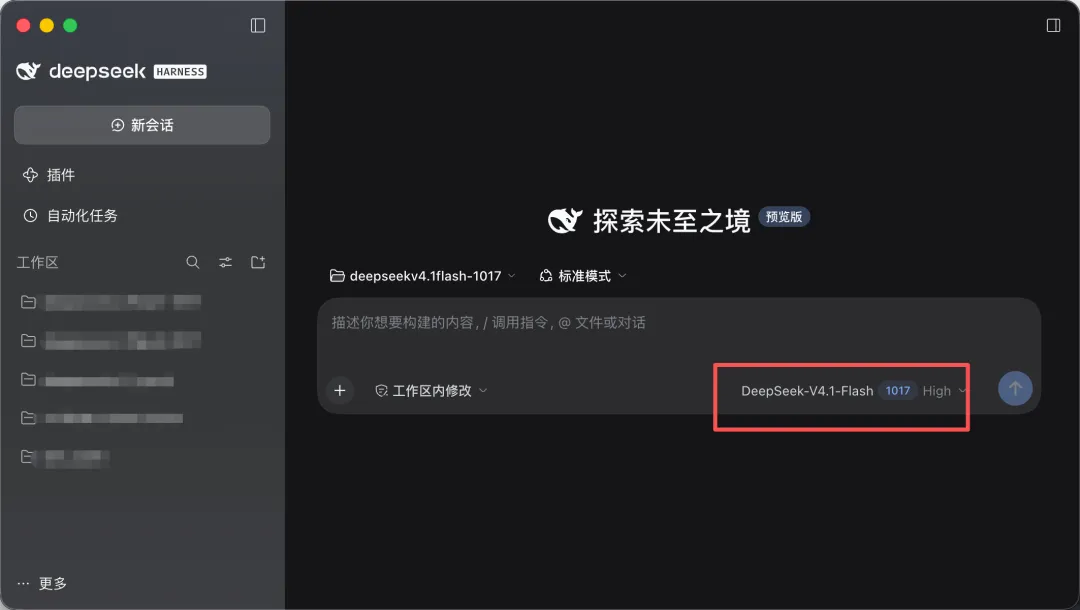
- 桌面端升级到 0.2.1-rc.1 或更高版本(旧版不适配新模型);
- 模型选带 1017 标记的 DeepSeek-V4.1-Flash,推理档位选 High(追求极限任务质量用 max):
另外两点:符合条件的用户首次登录 Harness 送 6 元赠金(不用充值,限量,7 天有效)——Flash 档本来就不贵,6 元足够把上面的案例全试一遍;官方这次还点名优化了腾讯 CodeBuddy 和 WorkBuddy,在这两个环境里用 Flash 的用户升级后直接受益。
六、顺带的一件大事:搜索 API 开放,11 月 1 日开始计费
这次更新里还有一条容易被忽略、但和所有 Agent 用户有关的:DeepSeek 把自家的搜索引擎开放成了 API。
背景是 DeepSeek 网页端和 API 的联网搜索一直由自研搜索引擎驱动(索引全球千亿级网页,每天处理数亿次请求),这次新增 Search(搜索)和 Fetch(抓取网页)两个接口,定价都是 5 元/千次。
要注意的是计费时间点:如果你在 DeepSeek Harness、Claude Code 或 Codex 里接的是 DeepSeek API,服务端的工具调用其实已经在访问这两个接口了——现在免费,北京时间 11 月 1 日 0 点起按次计费。
单看 0.005 元一次不贵,但 Agent 循环里搜索调用非常频繁(一次会话几十次很正常),一个深研任务循环 50 轮、每轮 2 次搜索就是 0.5 元,和模型 token 费用已经是同一量级。建议提前在代码里埋点统计调用量,别等账单来了才知道自己的搜索密度。
七、开源规格速查与适合谁
自托管团队关心的规格(个人用户可以跳过这节):
| 规格项 | 参数 |
|---|---|
| 总参数量(MoE) | 763B(每 token 激活 8B/16B) |
| 上下文 / 最大输出 | 1M / 384K tokens |
| 输入模态 | 图文交错(Vision 原生) |
| 开源协议 | MIT |
| 权重地址 | HuggingFace / ModelScope |
| API 价格(不变,每百万 token) | 非高峰 $0.15/$0.60,缓存命中 $0.003,高峰双倍 |
763B 的体量决定了这是数据中心选项,消费级显卡免谈——普通人老实用 API 或网页端。
怎么选:
- 跑批量 Agent 任务(自动化脚本、代码巡检、数据清洗):1017 没有对手,60 倍的成本差足以改变架构决策;
- 极致单点推理、终端编码上限:Opus 5 仍是天花板(HLE 56.3、Terminal-Bench 51.8),但单任务 79 元要想清楚,预算充足再上;
- 综合均衡:GPT-6 Astra 各项都稳,适合不差钱但要全能的场景——Astra 这类海外模型国内开通要网络环境,节点方案看科学上网完全指南,我自己用了六七年的一枝红杏新用户有 3 天 IEPL 专线试用;不想自己折腾账号的,环球巴士有 Astra 合租车位,新用户首单 9 折(优惠码
Tanqingbo),充值对比细节在GPT-6 Astra 指南和海外大模型充值教程里; - 多数个人用户和小团队:1017 够用,且几乎无成本压力——这是国产模型第一次把「单任务成本」打到这个量级。
说到底,这次更新没有发布会、没有新名字、没有价格战,但把性价比这个概念往前推了一步:比拼的不再是单价,而是完成一个任务要多少钱。跑分涨 11 个点、成本降 60%,Flash 这条产品线正在给 Agent 大规模跑批的经济模型重新定价——压力给到对面几家。
FAQ
Q:DeepSeek V4.1-Flash-1017 是什么?
2026 年 10 月 17 日发布的 V4.1 Flash 版本升级,版本号里的 1017 就是发布日期。网页端、APP 和 API 同步换新,API 调用方式和价格完全不变,模型名仍然是 deepseek-flash,老用户无感升级。
Q:1017 版比上一版强多少?
11 项基准全部上涨:Terminal-Bench 4.0 从 31.2 涨到 42.3(涨幅 11.1 个点,最大单项),DeepSWE v1.1 拿下 77.0 是六个模型里最高。但要诚实地说:对比表里 11 项中有 6 项的第一名仍是 Claude Opus 5,1017 的优势集中在 Agent 自动化任务和性价比,纯推理深度(HLE 42.6 对 Opus 5 的 56.3)还有差距。
Q:单任务 1.3 元是什么概念?
官方 DeepSWE v1.1 实测:1017 开到最高 max 档,通过率 77.0%,平均每个任务约 1.3 元;上一版同样任务要 3.3 元,降了六成。对比之下 Claude Opus 5 max 档通过率 73.7%、每任务约 79 元,GPT-6 Astra 约 30 元——同样的钱 1017 能跑约 60 个任务。API 单价一分没降,钱省在输出更短、跑得更快。
Q:「许愿式编程」是什么意思?
DeepSeek 对新版本能力的说法:像许愿一样用很少的提示词和参考素材,几轮交互就从零做出能跑的完整项目(游戏、3D 建模这类)。训练上是基于自反馈的强化学习,模型自己评估产出、自己修正。实际体验里一句话生成一匹奔跑的斑马、一句话做马里奥赛车,都是这个能力的体现。
Q:怎么用上 1017 新版?
三条路:网页端和 APP 已经自动换新,打开就用;API 老用户模型名不变(deepseek-flash),下次调用自动是新版;想体验完整「许愿式编程」的,把 DeepSeek Harness 桌面端升级到 0.2.1-rc.1 以上,模型选带 1017 标记的 DeepSeek-V4.1-Flash(High 档)。官方还针对腾讯 CodeBuddy 和 WorkBuddy 做了优化。
Q:DeepSeek Harness 首次登录有赠金吗?
有。符合条件的用户第一次登录 DeepSeek Harness 会发 6 元赠金,不用充值,限量发放,到账后 7 天内有效。Flash 档本来就不贵,6 元足够把许愿式编程的几个案例都试一遍。
Q:DeepSeek 搜索 API 收费是怎么回事?
这次同步开放了自研搜索引擎的 Search(搜索)和 Fetch(抓取网页)两个接口,定价都是 5 元/千次。在 DeepSeek Harness、Claude Code、Codex 里接 DeepSeek API 的话,服务端工具调用已经在用这两个接口,11 月 1 日 0 点前免费,之后按次计费。Agent 任务里搜索调用很频繁,建议提前统计调用量。
Q:1017 的权重开源了吗?什么规格?
开源了,HuggingFace 和魔搭都能下载,仓库名 DeepSeek-V4.1-Flash-1017,MIT 协议。规格:总参数 763B 的 MoE(每 token 激活 8B/16B)、1M token 上下文、最大输出 384K、图文交错输入。763B 的体量决定这是数据中心选项,个人本地部署不现实,普通人用 API 或网页端就好。
Q:DeepSeek API 怎么用更省钱?
两点:一是分时段,北京时间工作日 9:00-12:00 和 14:00-18:00 是高峰价(双倍),其余时间含周末全天都是半价,批量任务调度到非高峰能省一半;二是分档位,简单任务路由到 low 档(单任务约 0.75 元)、疑难任务才开 max 档(1.3 元),两档通过率只差 4.4 个点。
Q:V4.1-Flash-1017 和 GPT-6 Astra、Claude Opus 5 怎么选?
看任务类型和预算:批量 Agent 工作流、自动化脚本、代码巡检这类跑量任务,1017 的性价比没有对手;需要极致单点推理(HLE 类深度问题)或终端编码上限,Opus 5 仍是天花板但成本是 60 倍;综合均衡用 GPT-6 Astra 也可以,但单任务 30 元的成本要想清楚。多数个人用户和小团队,1017 够用且几乎无成本压力。
上手顺序:网页端直接体验(零操作)→ 想玩许愿式编程的升级 Harness 到 0.2.1-rc.1+ 选 1017 标记 → 领 6 元赠金把案例跑一遍 → 有批量任务的,11 月 1 日前统计好 Search/Fetch 调用量、把任务调度到非高峰时段。
想系统了解各大模型怎么选,回AI 工具完全指南总览页;想给 Harness 接上看图能力的,看DeepSeek 多模态实测。