10 月下旬,做「Vibe Modeling」的日本创作者 KOBATAKA 在 X 上晒了个挺离谱的成果:他睡觉去了,几个 AI 配合干了一夜(约 9 小时),做出了 1245 种低多边形物体,还装进了一款会越滚越大的游戏里。
具体分工是:DeepSeek V4.1 Flash 1017 不停造模型,Opus 5.5 负责指挥、做游戏和验收,Codex CLI 出参考图,Sonnet 5.5 参与部分审查。
「AI 能做游戏」这个结论没什么新鲜的。值得拆开看的是他怎么把一批昂贵和便宜的模型安排到各自合适的位置上:最贵的模型没有包办所有活,最便宜的也没有被要求一个人扛到底。
30 秒速答
- 案例:KOBATAKA 用多模型协作一夜产出 1245 种低多边形游戏素材,装进类《块魂》的滚动吞噬游戏
- 分工:Opus 指挥+游戏实现,DeepSeek 1017 专管批量建模,Codex 出参考图,Sonnet 参与审查,中间用任务看板串起来
- 成本:DeepSeek 建模部分约 25 美元,折算每种素材约 2 美分;Opus token 按 API 折算约 382 美元(实际走订阅)。分项口径,别直接除
- 工具链:Blender 建模 → 导出 GLB → Three.js 搭游戏
- 要复现先备网络:Opus、Codex、Sonnet 都是境外服务,得先有稳定的科学上网环境,怎么配看 Clash 完全教程
一、游戏本身:从一块键盘滚到一座城
玩法很直观:滚动,卷入小物件,让自己变大,再去卷之前碰不动的东西。
最开始视线几乎贴着桌面,键盘像一大片白色地形,旁边一只罐子就能挡住去路。键帽、线圈、杯子、电池、罐子,平时堆在桌上挺烦的一摊杂物,换了个尺寸视角,全都成了游戏内容。有点《块魂》的意思。
尺度是分段给目标的:
| 阶段 | 目标尺寸 | 能卷的东西 |
|---|---|---|
| 桌面 | 15 厘米 | 键帽、杯子、电池 |
| 房间 | 80 厘米 | 家具、散落物品 |
| 住宅周边 | 3 米 | 院墙、路灯、车 |
| 街区 | 40 米 | 房子、成片街区 |
几个细节值得记一笔:
- 房门不是一开始就开——团块到 50 厘米才出现开门提示。外面更大的空间看得见,但得先在眼前的杂物里把自己喂大。这个小安排把「捡什么」和「去哪里」串成了一个接一个的目标
- 镜头抬高不只是炫大场景,它在告诉玩家:现在能碰到另一批东西了
- 同一个动作换尺寸,能玩的内容就变了,不需要先看说明书
作者选了低多边形风格:保留主要轮廓和颜色,不追每只杯子的微小磨损。这个取舍对这种游戏很合适:玩家在移动、镜头在拉远、物体还要滚进越来越大的团块里,能一眼认出来、放在一起不别扭,比单独摆着有多逼真更重要。
二、素材怎么来的:一夜堆出 1245 种
先说一个口径问题:1245 是作者报告的素材种类数,不等于 1245 个互不重复的原创设计。公开说明没有拆出基础模型和尺寸变体的比例,总览里就能看到按尺寸分组的同款物件:3 厘米以下一组、3 到 10 厘米一组、家具车辆房屋,后面还有「家具的 10 倍」这种巨大版本。
不过对这种游戏来说,种类多是真的有用。一路只能捡同样的方块的话,尺寸在变、惊喜很快就没了;不断碰到形状和用途不同的东西,才有「这个居然也能卷走」的感觉。
模型进游戏的路径也交代了:Blender 建模,导出 GLB,再用 Three.js 构建游戏。
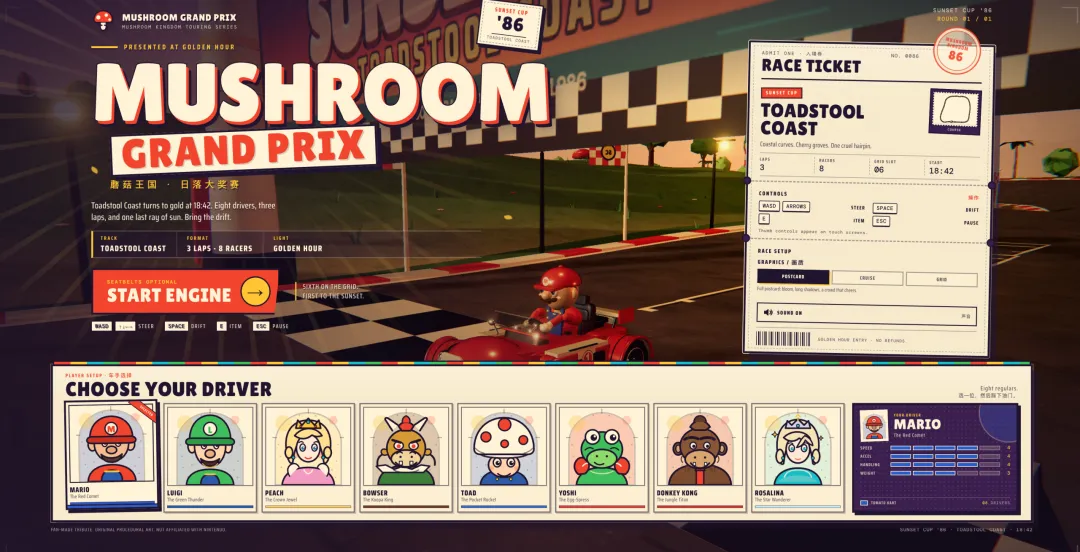
同一颗 1017 在站内实测里也干过类似的事:一句提示词直出能玩的赛车游戏,建模、搭场景、做交互一条龙。本案例把这类能力拆成专职建模工位,成规模地用。
GLB 可以理解成装好模型数据的文件包,形体、材质一起带走,交给另一个程序读取,它不是一张「看起来像模型」的图片。这一步把工作切开了:造杯子的一端把杯子做成约定格式,游戏这一端决定放哪、镜头怎么看、什么时候能被卷走。
能做出一个物体,和能把上千种物体接进同一个游戏,是两件不同的事。作者这次公开的分工,恰好就在中间搭了道桥。
三、分工架构:Opus 派活,DeepSeek 不停造
作者自己写的分工是:
- Opus 5.5 Med:指挥 + 游戏实现
- DeepSeek 建模端(经 dsh 调用):专做物体建模
- Codex CLI:由 Opus 无头调用,提供参考图
- Sonnet 5.5 Med:参与部分审查
「无头」就是不必人工盯着一个交互窗口点来点去,一个任务把另一个工具叫起来,拿到结果接着往下走。
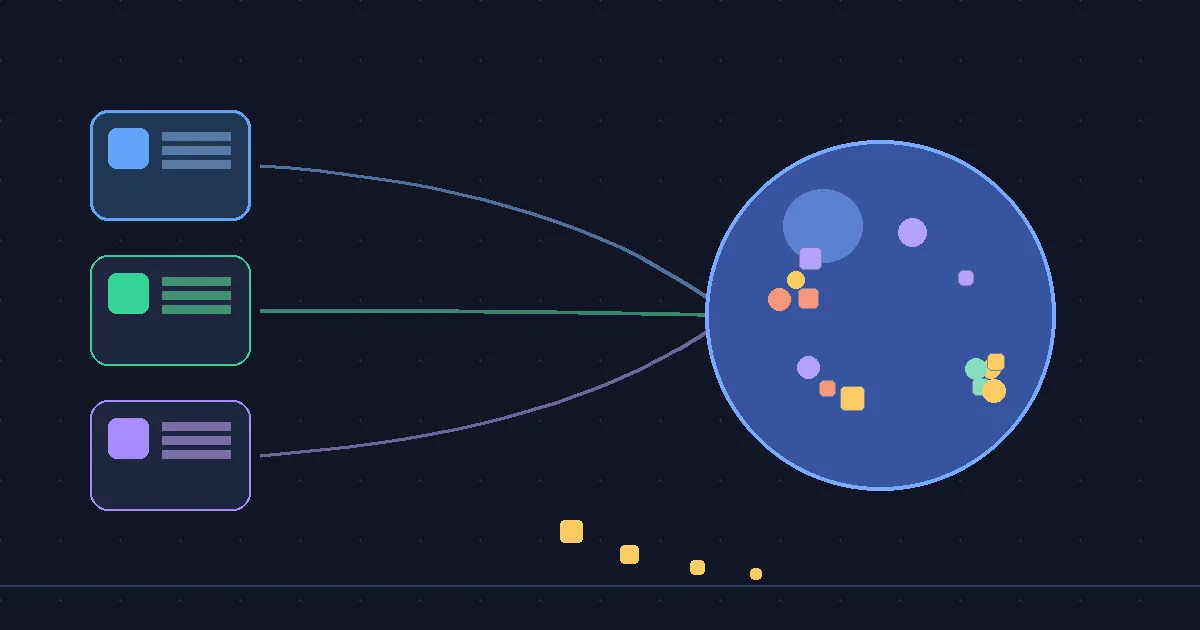
真正把这几端串起来的,是作者自制的任务看板。流程是:Opus 登记任务 → DeepSeek 持续建模 → Opus 检查 → 合格的才采用。
这跟让几个聊天窗口各自想办法差别挺大。游戏需要什么物件、模型交回来放到哪里、哪些结果能收进项目,总得有个地方记着,否则做得越快剩的对不上文件越多。看板提供了共同去处:任务被登记、结果被接收、再进下一步。
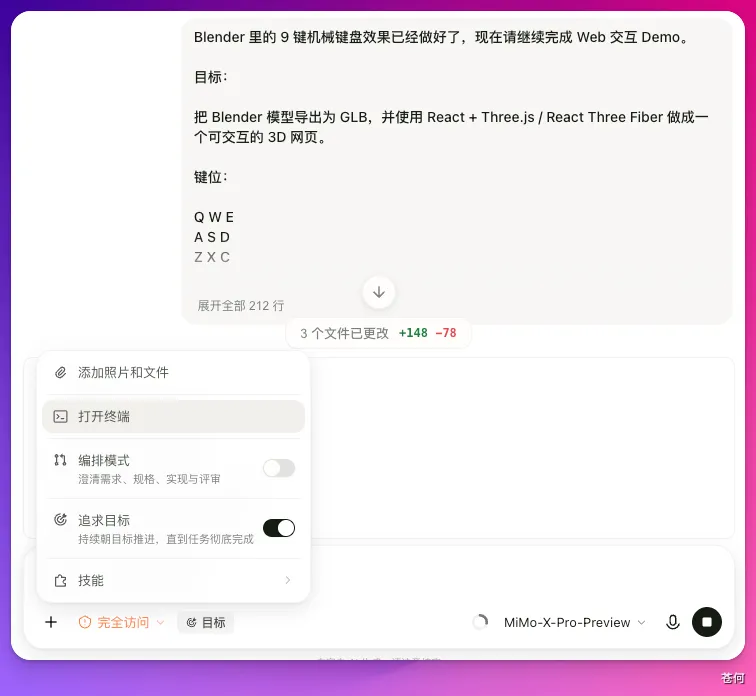
站内另一篇实测里桌面 Agent 的 Goal 模式长这样:目标挂在面板上,拆成步骤持续推进,卡住自己调整。本案例作者自制的看板管的是同一件事,只是角色换成了 Opus 派活、DeepSeek 交活。
「合格再采用」这四个字最值得盯。模型把文件生成出来,不自动等于游戏拿到了可用素材——比例、朝向、外观对不对都是实际问题,一个漂亮杯子如果大得像房子,照样得退回。检查由谁做,没有「生成了多少件」吸睛,却决定后面的活能不能继续。
作者也说了,他是有意把思考、质量检查和执行分开,让成本安排更合理。同一份项目里几家模型能一起出现,谁适合留在哪一步,最后要看事情能不能接着做下去。
四、成本账:25 美元很抢眼,但有后半句
作者报告 DeepSeek 建模部分花了约 25 美元。在 1245 种素材旁边,这个数字很容易让人心动。按他报告的口径粗算,摊到每种素材头上大约 2 美分——比任何手工外包的报价单都低几个数量级。
但他同时写了另一个数字:Opus 5.5 消耗的 token 按 API 价格折算约 382 美元。
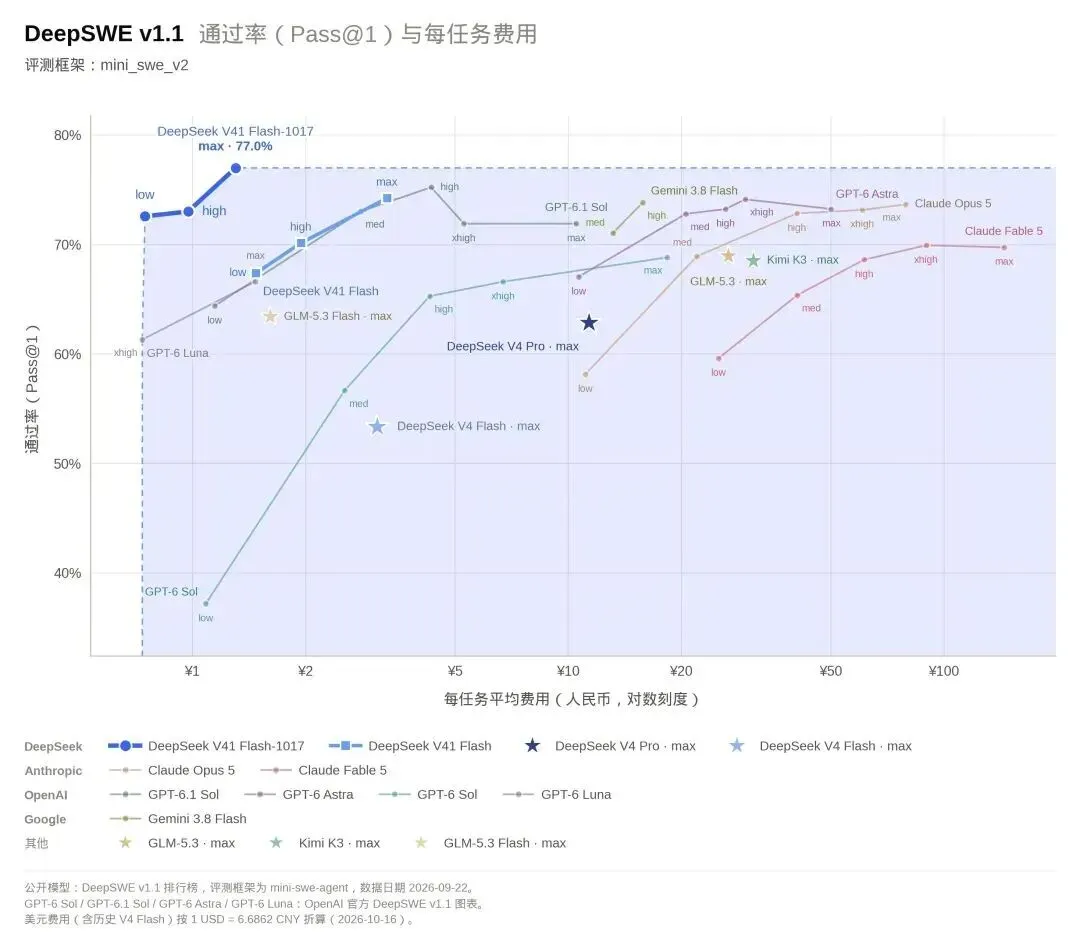
官方的性能-费用图能解释作者为什么把量产活交给 1017:同一批任务里它落在「通过率高、单次费用低」的角落。量产工位要的就是这个形状。
这两个数不能直接除一下就说 DeepSeek 便宜了多少倍:
- 工作内容不同:DeepSeek 主要在建模,Opus 承担指挥、游戏实现和检查
- 382 美元是 API 折算口径,他实际用的是 100 美元订阅计划,碰到 5 小时限制后用了奖励额度
- Codex 和 Sonnet 没有单列费用,所以这不是项目总支出
把口径放回去,25 美元仍然有吸引力,尤其项目需要大量相似却又不能完全相同的内容时。做一个杯子可以接受多折腾几轮;一屋子的杯子罐子桌椅,每次都守着就不轻松了。把一批需要耐心的活交出去、自己不用逐件盯着,正是这类工作流的价值所在。
但他没把贵的模型全撤掉。有人问他:为什么不让 DeepSeek 自己当指挥?他的回答挺克制——在他这类指挥任务上 DeepSeek 目前不如 Opus 5.5,长任务里前面小错后面连环错,所以暂时让 Opus 带队。
这条判断引出的问题,比低价数字重要:便宜的执行,依然需要有人管住方向和质量。指挥从一开始就拆偏了,后面再做几百件也只是更勤快地走错路。保住检查的位置,可能比再压一点单次生成费用更要紧。
五、要复现,准备三件事
作者白天先做了一个 mock 雏形并审过一轮,夜里才是流水线跑起来的 9 小时。方向、初版、看板和工具的连接都是事先准备好的。想复现这种玩法,清单如下:
1. 网络条件先过关
分工里最贵的三层全是境外服务:Opus(Anthropic)、Codex(OpenAI)、Sonnet(Anthropic),国内直连连登录页都打不开。先配好稳定的代理环境再谈协作,Windows 端看 Windows 科学上网教程,方案选型看 科学上网完全指南。DeepSeek 倒是国内直连可用,这也是它能当「便宜劳动力」的前提之一。
2. 工具链就位
建模端 Blender(导出 GLB),游戏端 Three.js。GLB 是中间的约定格式,形体和材质打包带走。游戏开发本身如果想让 AI 接手更多,可以看 Codex 安装使用教程 和 GPT-6 Astra 写代码实测。
3. 任务看板比模型更决定成败
登记需求、接收结果、控制合格率,这三件事没地方记,模型越多越乱。作者的做法是 Opus 登记和验收、DeepSeek 执行,实际组织方式可以换,但「有人管方向、有人管检查」的结构不能省。模型怎么选、怎么搭,AI 编程工具怎么选 里有对比。
另外这案例里的主角模型 DeepSeek V4.1 Flash 1017 的能力细节和单价(单任务 1.3 元),在 1017 版本详解 里单独讲过,这里不重复。
常见问题解答(FAQ)
这个案例里的游戏是什么玩法?
类《块魂》的滚动吞噬玩法:玩家操控一团东西在桌面滚动,卷入键帽、杯子等小物件变大,再卷更大的物体。场景从桌面(15 厘米)一路到街区(40 米),尺度分段给目标,越滚越大。
1245 种素材都是互不重复的原创设计吗?
不是。1245 是作者报告的素材种类数,公开说明没有拆出基础模型和尺寸变体的比例,不能直接当成 1245 个独立原创设计。已公开的总览里就能看到按尺寸分组的同款物件(如「家具的 10 倍」版本)。
这几个模型的分工是怎么安排的?
Opus 5.5 当指挥并做游戏实现,DeepSeek V4.1 Flash 1017 专做建模,Codex CLI 被 Opus 无头调用提供参考图,Sonnet 5.5 参与部分审查。中间用作者自制的任务看板串流程:登记任务、持续建模、检查、合格采用。
DeepSeek 造素材真的只花了 25 美元吗?
25 美元是作者报告的 DeepSeek 建模部分花费。Opus 消耗的 token 按 API 折算约 382 美元(他实际用的是 100 美元订阅计划),Codex 和 Sonnet 未单列费用。这是分项口径,不是项目总账。
为什么不让便宜的 DeepSeek 直接当指挥?
作者的判断是:在他这类指挥任务上 DeepSeek 目前不如 Opus 5.5。长时间任务里前面出小错后面会连环错,所以指挥和检查的位置暂时留给更强的模型。他也说了下次会试着让 DeepSeek 做游戏核心开发再对比。
我想复现这种多模型工作流,要准备什么?
三件事:一是网络条件(Opus、Codex、Sonnet 都是境外服务,需要稳定的代理环境);二是工具链(Blender 建模导 GLB,Three.js 搭游戏);三是一个任务看板(登记需求、接收结果、控制合格率),看板往往比模型本身更决定成败。
写在最后
这个案例最有信息量的地方,不是「AI 一夜做了 1245 个模型」这种数字,而是它把一件以前说不清的事说清楚了:多模型时代的工作分配,跟人的团队管理是同构的。贵的留决策和验收,便宜的做量产,中间用流程把两边接住。
作者还留了一句:下次试试让 DeepSeek 做游戏核心开发。到时候账单会怎么变、游戏还顺不顺,才是这套分工真正的对照实验。我们到时候再拆。